Anthropic 在 2026 年 9 月 28 日發表 Claude Sonnet 5.5。這次不是降低 API 單價:每百萬 input/output token 仍是 2/10 美元;官方宣稱新版輸出速度比 Sonnet 5 快逾 30%,而且多數工作所需的 token 更少,單項任務成本最多可降 30%。這是 Anthropic 的測試結果,實際節省幅度會隨任務與 effort 設定改變。
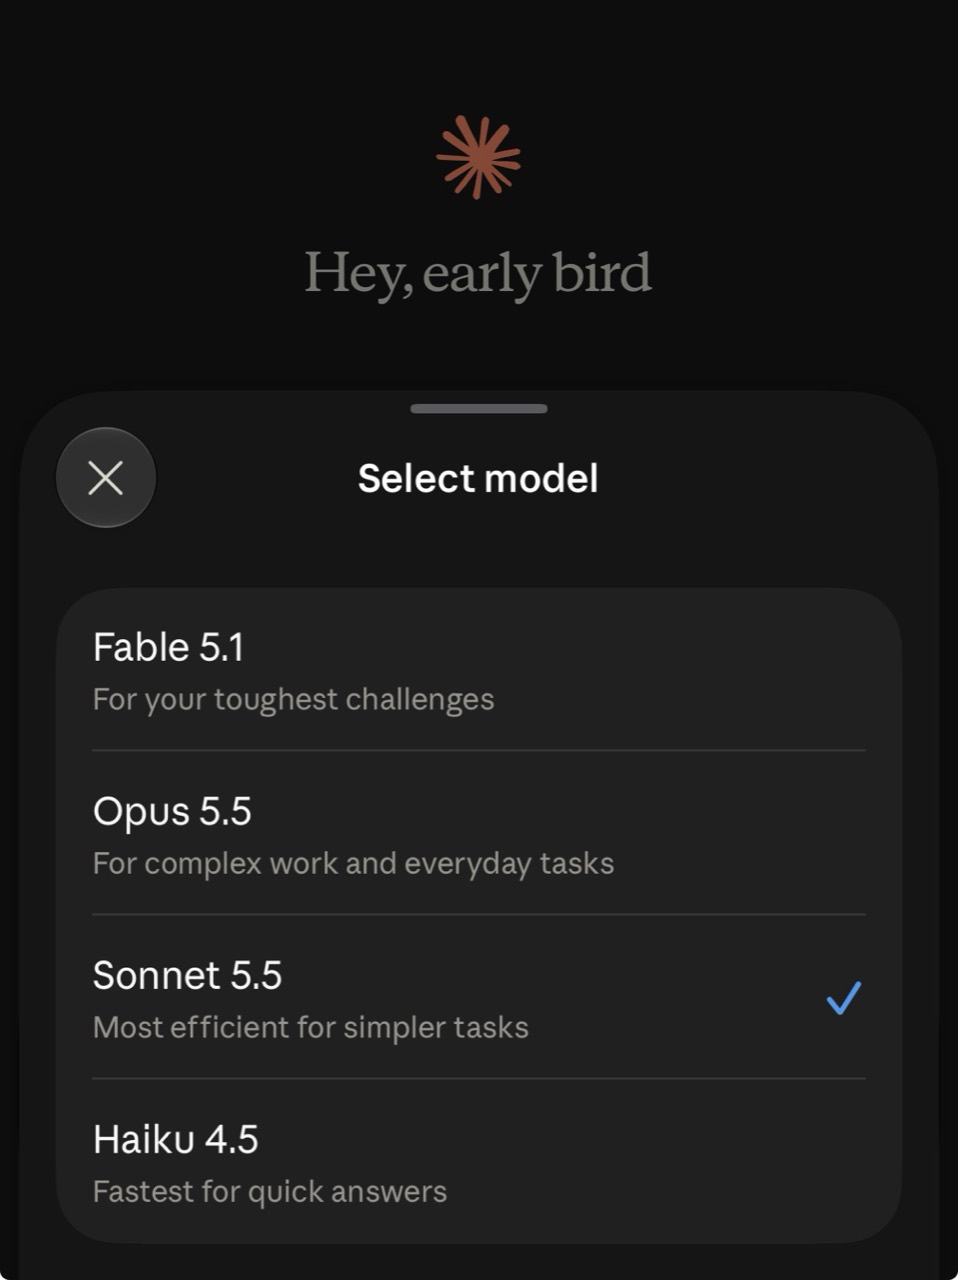
手機版 Claude 的模型選單已出現 Sonnet 5.5,提供一般使用者直接切換的入口;是否看得到選項,仍要以帳號與工作區設定為準。
Claude Sonnet 5.5 是什麼
先看一段由 Sonnet 5.5 使用網頁動畫做的自我介紹。
Claude 是 Anthropic 開發的 AI 助理與模型系列,可以閱讀文件與圖片、寫程式、整理資料,也能在允許的工具環境執行多步驟工作。Claude App 是網頁、桌面與手機上的對話產品;Claude Code 是在終端機及開發環境工作的 coding agent。Sonnet 是其中兼顧速度、能力與用量的模型,5.5 版接替 6 月推出的 Sonnet 5,成為 Claude 5.5 家族繼 Opus 5.5 後的第二款模型。
官方把 Sonnet 5.5 放在範圍明確的日常工作,例如修正程式錯誤、製作文件、簡報、試算表與介面設計;Opus 5.5 仍偏向需要長時間判斷的複雜、開放式任務。兩者不是單純「能力高低」或「速度快慢」的替換關係:任務越明確、執行越頻繁,Sonnet 的效率優勢越值得試;需求不清、需要持續權衡與查核時,先考慮 Opus。Anthropic 預告 Haiku 5.5 之後才會加入;目前手機版選單中的 Haiku 仍是 4.5。
| 模型 | 目前定位 | 選用時機 |
|---|---|---|
| Fable 5.1 | 最困難的挑戰 | 更高強度的長時間推理與 Agent 工作 |
| Opus 5.5 | 複雜工作與日常任務 | 範圍開放、需要持續判斷的工作 |
| Sonnet 5.5 | 較簡單任務的高效率選擇 | 明確的 coding、文件與設計任務 |
| Haiku 4.5 | 快速回答 | 低延遲的簡短問題 |
Claude App 與 Claude Code 怎麼用 Sonnet 5.5
這一節給使用 Claude 現成產品與訂閱方案的讀者,不需要設定 API。Anthropic 表示 Sonnet 5.5 已在 Claude 各平台推出;在網頁、桌面或手機 App,點送出鍵旁的模型名稱,從選單選 Sonnet 5.5。Claude Code 可輸入 /model 切換。發表文沒有逐一公布 Free、Pro、Max、Team 與 Enterprise 的 Sonnet 5.5 配額或預設模型;具體選項仍受帳號方案、逐步開放與工作區管理員設定影響。免費帳號不能因 App 可選到 Sonnet 5.5,就推定也可使用 Claude Code。
Effort 預設與調整
Anthropic 的發表文說明,Sonnet 5.5 在 Claude App 與 Claude Code 預設 Medium effort,直接使用 Claude Platform API 則預設 High。Effort 控制回答時投入的思考量:Low、Medium 通常較快、消耗較少 token;High 以上會花更多時間與用量查核,適合較複雜的工作。它不是固定的品質排名,也不保證調到最高就一定比較正確。
App 可在模型選單的「Effort」調整,同一段對話從下一次回覆生效;Claude Code 則可用 /effort medium 作為日常檔位,遇到跨檔案重構或複雜推理再提高。Anthropic 沒有在這次 Sonnet 5.5 發表文宣布額外提高五小時額度或另送一張免費重置券;9 月 Opus 5.5 的用量與重置券活動不要直接當成 Sonnet 5.5 的新活動。已取得的券及可用額度,仍以帳號頁面顯示為準。
安全機制可能改用 Sonnet 5 回答
Sonnet 5.5 是首款加入較高風險資安請求切換機制的 Sonnet。若對話觸發相關防護,Claude 可能顯示通知,改由 Sonnet 5 回答,模型選單也會停留在 Sonnet 5;一般修 bug、檢查自己的程式碼不在官方所述的主要影響範圍。若不希望自動切換,可到 Settings → Capabilities 關閉「Switch models when a message is flagged」;Claude Code 的位置是 Config → MODEL & OUTPUT。關閉後,符合條件的請求會暫停,而不是保證由 Sonnet 5.5 繼續處理。
速度與能力比 Sonnet 5 改進多少
以下數據來自 Anthropic 公布的測試,並非獨立實測。官方宣稱 Sonnet 5.5 的輸出速度比 Sonnet 5 快逾 30%,且在多數工作中以更少的 token 完成任務。對訂閱者,體感可能是等待時間縮短、同樣用量能完成更多工作;但方案額度如何計算,不能直接用「快 30%」或「每任務省 30%」換算成固定可多問幾次。
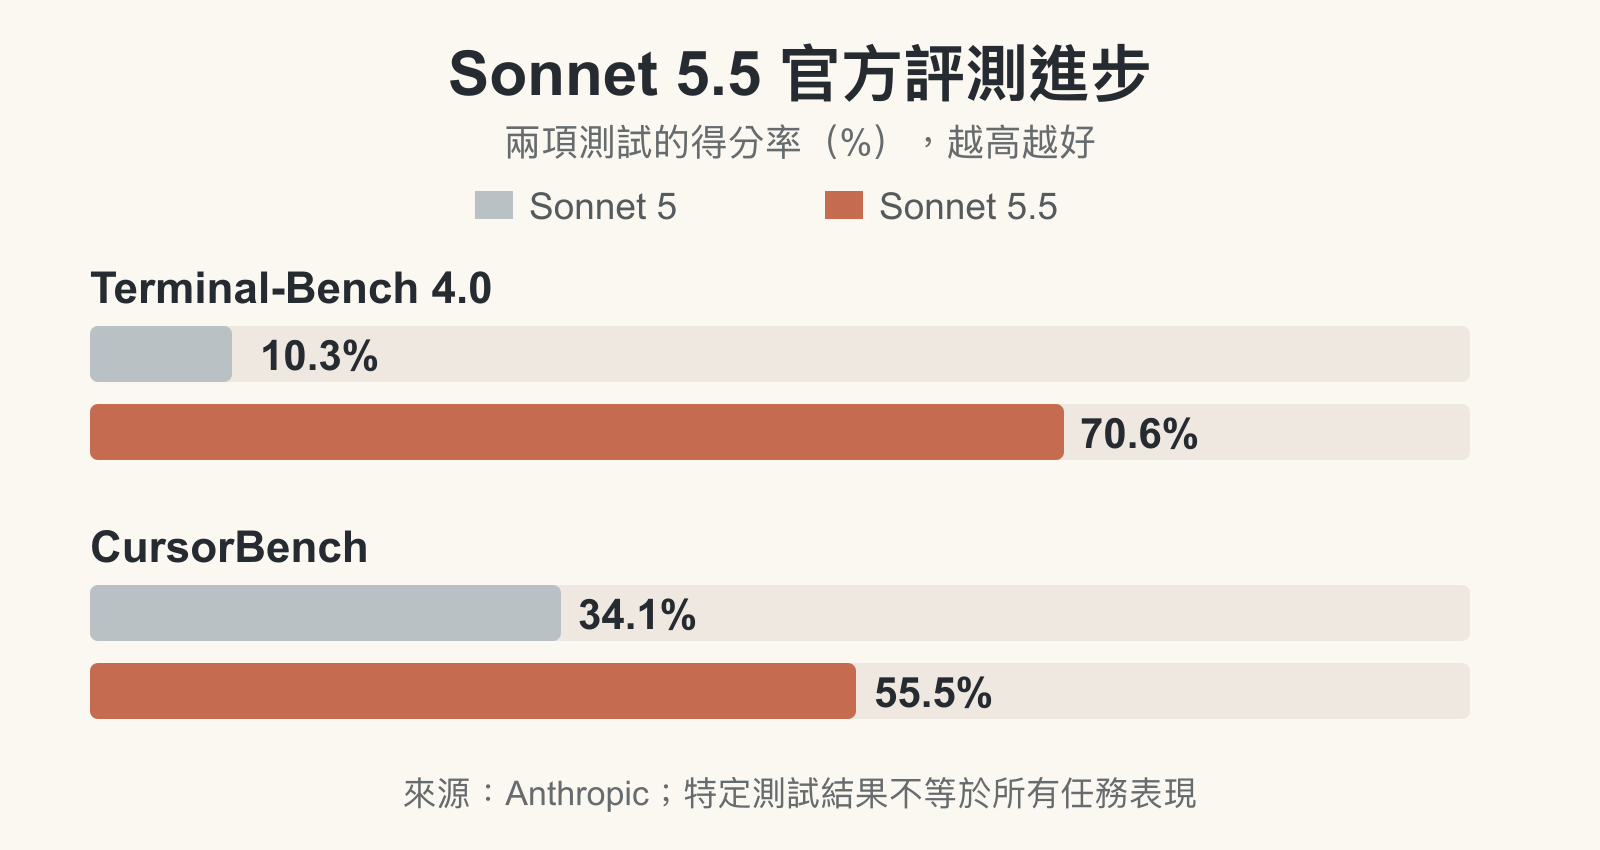
Anthropic 的 完整官方評測 涵蓋 coding agent、知識工作、多學科推理、電腦操作與圖表辨識,Sonnet 5.5 在列出的八項都高於 Sonnet 5。表中是各模型在官方所列設定下的結果,不代表三款模型都使用相同 effort。
| 評測 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4%(Xhigh) |
| FrontierCode 1.1(Main) | 52.1%(Xhigh)/46.2%(Max) | 42.4% | 54.4% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% |
| GDPval-AA v2.1 | 1844 Elo | 1449 Elo | 1846 Elo |
| AA-Briefcase v1.1 | 1811 Elo | 1359 Elo | 1822 Elo |
| Humanity’s Last Exam(有工具) | 64.5% | 54.9% | 67.7% |
| OSWorld 2.1(partial) | 80.1% | 57.0% | 81.8% |
| Chartography(無工具) | 61.6% | 15.6% | 64.4% |
這次 Sonnet 5.5 相較 6 月 30 日發表的 Sonnet 5,各項成績有大幅進步,甚至 Terminal-Bench 4.0 的成績還超越 Opus 5.5。這項評測聚焦命令列中的多步驟任務:Sonnet 5.5 得到 70.6%,Opus 5.5 在 Xhigh effort 下得到 66.4%。這不表示 Sonnet 5.5 整體能力更強;Anthropic 將它定位於範圍明確的工作,因此這類題目可能較能發揮它的長處。Anthropic 也指出,Opus 5.5 的評測啟用了正式安全防護,部分題目觸發防護時會交由較舊模型處理,可能拉低分數。不過,官方沒有逐題分析這 4.2 個百分點的差距,無法確認哪個因素是主因。
CursorBench 測真實開發工作階段中的跨檔案修改,Sonnet 5.5 的 55.5% 也高於 Sonnet 5 的 34.1%。GDPval-AA 測跨職業知識工作,AA-Briefcase 測較長時間的知識工作,兩者採 Elo 分數,不能當成答對百分比。Sonnet 5.5 在這兩項分別得到 1844 與 1811,接近 Opus 5.5 的 1846 與 1822;圖表辨識的 Chartography 則從 Sonnet 5 的 15.6% 升至 61.6%。
官方的分數與每任務成本曲線顯示,Sonnet 5.5 在 Medium effort 的 Terminal-Bench,以及 Low effort 的 CursorBench,分數都高於 Sonnet 5 的最佳成績,單題成本不到後者的一成。這是指定評測流程的任務成本,不代表 API 每 token 單價降到十分之一。
這八項均為 Anthropic 公布的結果。Terminal-Bench 的 Opus 5.5 分數採 Xhigh effort;FrontierCode 中 Sonnet 5.5 的 Xhigh 反而高於 Max,官方註明 Max 在部分題目做了超出範圍的修改或逾時。GDPval-AA 與 AA-Briefcase 的 Sonnet 5.5 分數來自發表前版本,當時結構化輸出曾有錯誤,Anthropic 表示問題已修正。不同工具、測試流程與 effort 都會影響結果,不能把分數差直接換算成日常工作的成功率;官方也表示,複雜且開放式的長時間任務仍以 Opus 5.5 較強。
One-shot 太陽系互動展示
這個 太陽系模擬器互動網站 是在 Sonnet 5.5 的 Extra effort 設定下,以單次提示完成的。作品包含八大行星、月球與哈雷彗星;太陽表面流動、行星光暈、土星環、銀河、小行星帶與偶爾劃過的流星,則構成畫面特效。這是該次作品的設定與成果,不代表 Sonnet 5.5 的預設 effort,也不等於每次 one-shot 都能產出相同品質。
手機若需要更大的操作畫面,可 另開完整的太陽系模擬器。
當時使用的完整提示詞是:「做一個模擬太陽系可以互動的網頁,還要重視漂亮的特效、手機與電腦都有好體驗」。
電腦上可拖曳旋轉視角、用滾輪縮放,點選天體查看直徑、公轉週期、溫度、距太陽的距離與光行時間;手機上則可單指旋轉、雙指縮放,從下方天體列切換觀看對象。時間控制支援暫停、倒轉與最高每秒 10 年,作品說明以 2061 年哈雷彗星接近太陽、拖出兩條尾巴作為觀看例子。網站稱行星位置依 JPL 公布的軌道要素計算,距離與大小則為方便觀看而壓縮;這是模擬器自身的說明,天文計算精度尚未獨立驗證。
同一段提示詞也交給 Extra effort 的 Opus 5.5 製作 另一版互動太陽系。Opus 版本使用 NASA 影像製作的地球與月球紋理,放大地球時可看見更細緻的地表、雲層與夜間燈光;銀河背景與整體光影也更豐富。不過,它沒有做出 Sonnet 版本的哈雷彗星。兩者是作品差異,不代表模型能力排名;Opus 版本也收錄在 Opus 5.5 介紹文章。
Sonnet 5.5 的 API 價格與六款模型比較
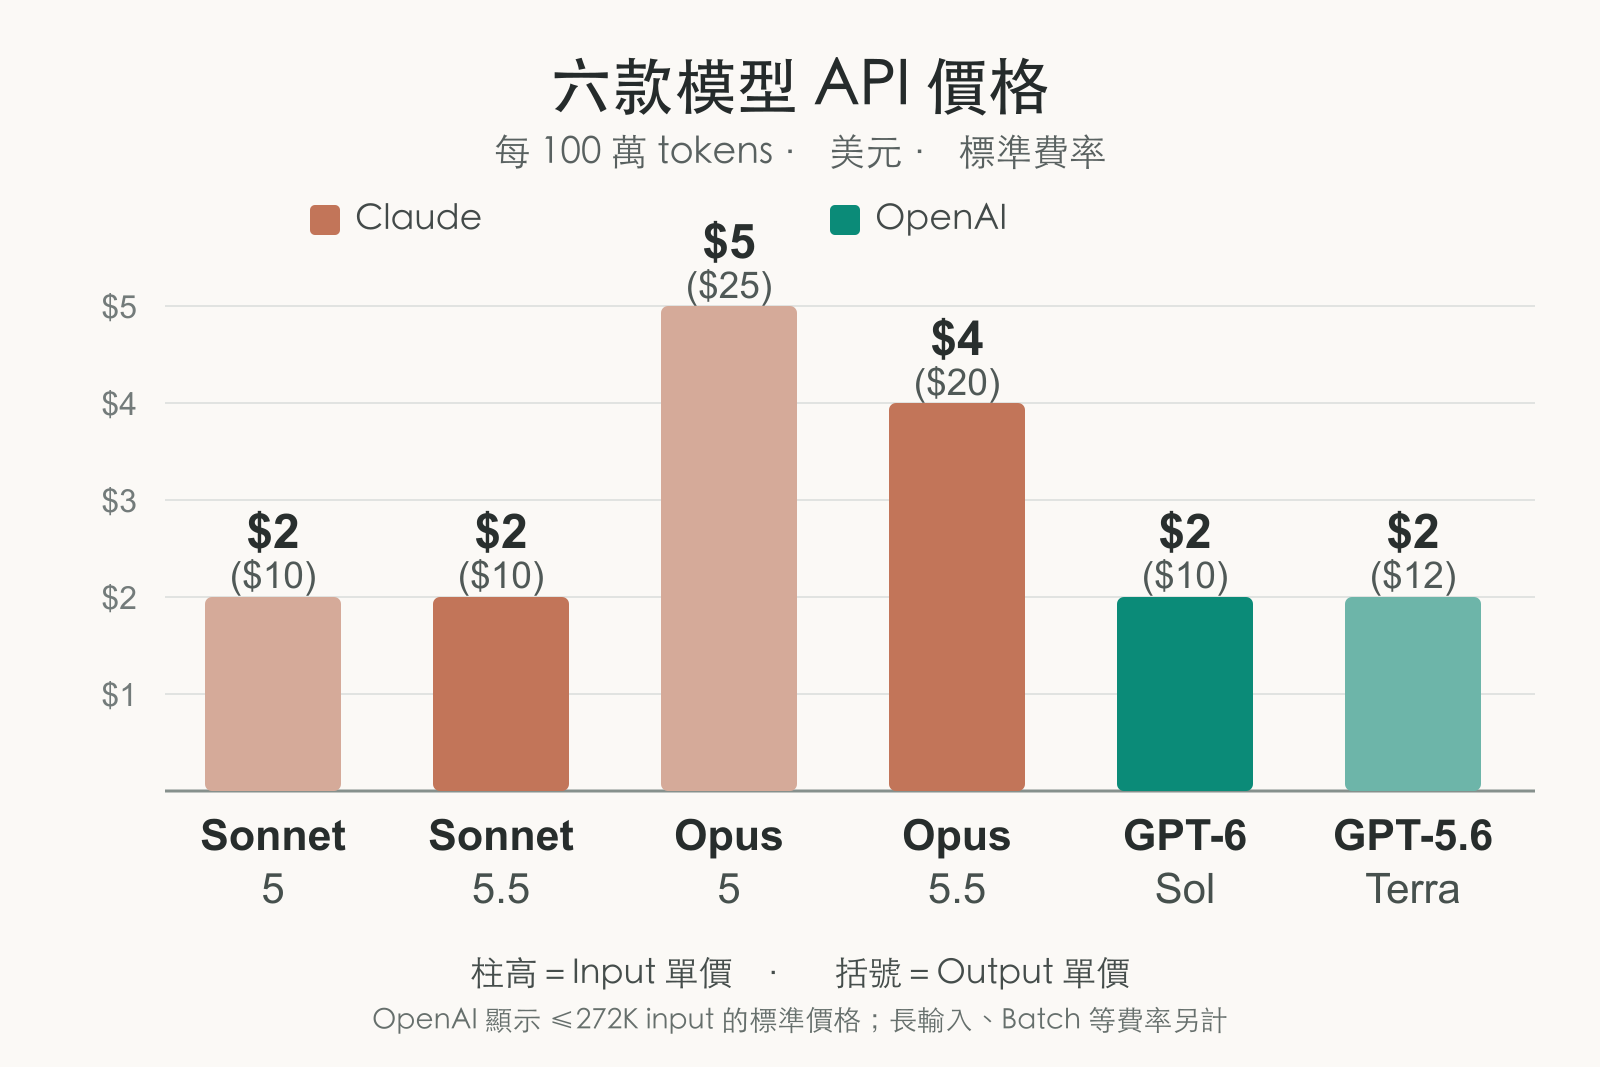
以下是開發者直接呼叫 Anthropic 或 OpenAI API 的標準文字 token 費率,與 Claude App、Claude Code 或 ChatGPT 的訂閱費及用量限制分開計算。Sonnet 5.5 的 input、output 單價與 Sonnet 5 相同;與 Opus 5/5.5、GPT-6 Sol、GPT-5.6 Terra 同框比較,可看出各模型的價格位置。Anthropic 所說的「最多省 30%」是特定測試的每項任務總成本,不是 Sonnet 5.5 的逐 token 單價下降。
| 模型 | Input/百萬 tokens | Output/百萬 tokens | 快取讀取/百萬 tokens |
|---|---|---|---|
| Sonnet 5 | 2 美元 | 10 美元 | 0.20 美元 |
| Sonnet 5.5 | 2 美元 (約新台幣 64 元) | 10 美元 (約新台幣 318 元) | 0.20 美元 |
| Opus 5 | 5 美元 | 25 美元 | 0.50 美元 |
| Opus 5.5 | 4 美元 (約新台幣 127 元) | 20 美元 (約新台幣 636 元) | 0.20 美元 |
| GPT-6 Sol | 2 美元 (約新台幣 64 元) | 10 美元 (約新台幣 318 元) | 0.20 美元 |
| GPT-5.6 Terra | 2 美元 (約新台幣 64 元) | 12 美元 (約新台幣 382 元) | 0.20 美元 |
Sonnet 5.5 與 GPT-6 Sol 的標準 input/output 都是每百萬 tokens 2/10 美元;GPT-5.6 Terra 的 input 同為 2 美元,output 則是 12 美元。Opus 5.5 相較 Opus 5,input、output 各降 20%,快取讀取由 0.50 降至 0.20 美元。這些單價不能代表完成同一任務的總費用或模型能力排名。GPT-6 Sol 與 GPT-5.6 Terra 若單次請求的 input 超過 272K tokens,官方對整筆請求按 input 2 倍、output 1.5 倍計價;Batch、Fast Mode 等也有不同費率。
Sonnet 5.5 的模型 ID 是 claude-sonnet-5-5,context window 為 100 萬 tokens、單次最多輸出 12.8 萬 tokens;Message Batches API 的 30 萬 output tokens 仍需指定 beta header。一般 API 的 5 分鐘/1 小時快取寫入價分別是每百萬 tokens 2.50/4 美元,Batch API 對 input、output token 另有 50% 折扣。這些是開發者價格與上限,不等於 App 一次對話一定可送滿 100 萬 tokens。
API 從 Sonnet 5 升級的注意事項
這一節只給直接組 Claude Messages API 請求、維護 SDK 或自建 Agent 的開發者。單純在 Claude App 選模型或在 Claude Code 執行 /model,不需要手動修改下面的 request 參數。除了把模型 ID 換成 claude-sonnet-5-5,至少要檢查四處相容性:
- 原本關閉 thinking:Sonnet 5 的
thinking: {"type":"disabled"}在 5.5 會回傳 400;若目的是不要先花時間思考,改用between_tools。它只支援 Low、Medium、High effort,不能和 xhigh、Max 合用。 - 原本強制呼叫工具:
tool_choice指定any或tool會回傳 400;改用auto,需要驗證工具參數時依平台支援情況使用 strict tool,並在程式端處理模型不呼叫工具的分支。 - 原本使用電腦操作工具:Claude API 與 Google Cloud 的舊版
computer_20251124工具不能直接沿用,應換成官方新 toolset。工具間的進度文字也可能改放在 thinking block;若自建介面會串流顯示這段文字,需調整解析方式。 - 原本會修改舊對話內容:Sonnet 5.5 的 thinking block 與模型及對話綁定;自建流程若回頭改 system prompt、工具定義或早期訊息,再重送舊 thinking block,部分帳號會得到 400。優先維持對話歷史只追加不改寫,並依遷移文件處理跨模型或跨帳號的 thinking block。
Sonnet 5.5 沿用 Sonnet 5 的 tokenizer,同一段文字不會因換版就重新膨脹成更多 token;但模型實際會思考、呼叫工具及輸出多少內容仍可能不同。升級前應用自己的代表性任務核對結果與成本,不能把官方「最多省 30%」當成所有工作負載的固定預算。
參考來源
- Anthropic: Introducing Claude Sonnet 5.5 (Sonnet 5.5 發表與官方評測)
- Claude Platform Docs: Claude Sonnet 5 (Sonnet 5 價格)
- Claude Platform Docs: Claude Sonnet 5.5 (規格與 API 價格)
- Claude Platform Docs: What’s new in Claude Sonnet 5.5 (模型行為與 tokenizer)
- Claude Platform Docs: Migrating to Claude Sonnet 5.5 (API 升級與相容性)
- Claude Platform Docs: Claude Opus 5 (Opus 5 原價)
- Claude Platform Docs: Claude Opus 5.5 (Opus 5.5 新價)
- OpenAI API: GPT-6 Sol Model (GPT-6 Sol 標準 API 價格與長輸入加價)
- OpenAI API: GPT-5.6 Terra Model (GPT-5.6 Terra 標準 API 價格與長輸入加價)
- Claude Help Center: Change the model, effort, and thinking settings (模型與 effort 切換)
- Claude Help Center: Why Claude switched models in your conversation with Sonnet 5.5 (安全切換機制)