OpenAI 在 2026 年 10 月 26 日公開論文〈The Exponential Time Hypothesis is False〉,宣稱內部模型找到一個確定性演算法,也就是不靠隨機猜測、每次結果都相同的演算法,能在次指數時間解出 3-SAT 問題。幾小時後,Anthropic 也公開由 Claude 署名的〈A 2o(n) Time Algorithm for 3-SAT〉,用不同的主要做法得到同樣的結論。兩篇都附上 Lean 4 形式化證明,也就是交給證明檢查程式逐步驗證的版本。
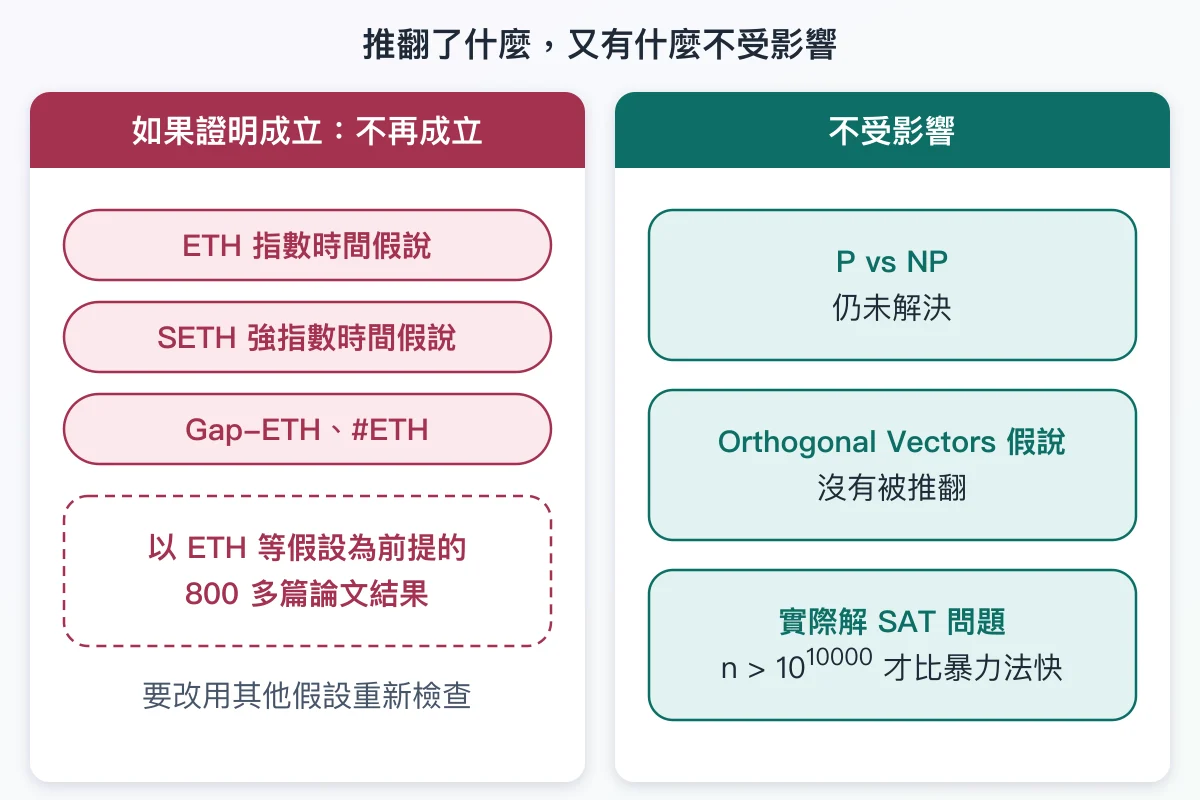
如果證明成立,計算複雜度理論沿用約 25 年的指數時間假說(ETH)就不成立,800 多篇以它或相關假設為前提的論文結果要重新檢查。這篇會從 3-SAT 與 ETH 是什麼開始,把兩種演算法的做法、學界驚訝的原因、影響範圍與驗證進度一起整理。
3-SAT 與指數時間假說是什麼
3-SAT 是判斷一組邏輯條件能不能同時成立的問題。公式由許多「子句」組成,每個子句最多有 3 個變數或變數的否定,用「或」連接;整個公式成立,代表每個子句都至少有一個值為真。題目要問的是:有沒有一組 0 與 1 的值,讓所有子句同時成立。
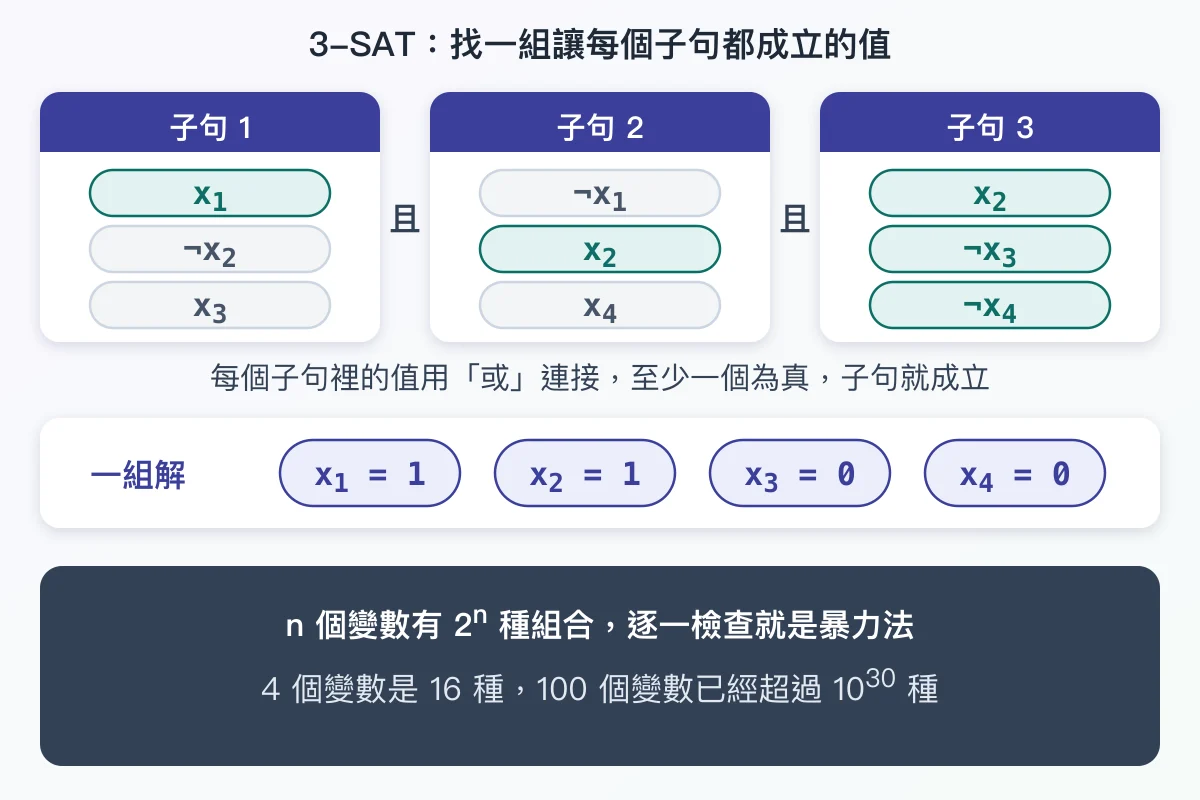
給一組值,很快就能驗證它對不對;要找出一組值,最直接的方法是把 2n 種組合全部試過。1971 年 Cook 證明 SAT 是 NP 完全問題:所有「答案容易驗證」的問題,都能改寫成 SAT。排程、硬體驗證、軟體測試等大量問題都能化成 SAT,所以它一直是計算複雜度理論的重要研究對象。
指數時間假說(Exponential Time Hypothesis,ETH)是 Russell Impagliazzo 與 Ramamohan Paturi 在 1999 年提出、2001 年正式發表的猜想。演算法可以把 2n 的底數往下壓,例如 1.3n,但 ETH 主張不管怎麼壓,3-SAT 在最壞情況下都至少要 2δn 的時間,δ 是某個大於 0 的常數;換句話說,3-SAT 做不到次指數時間 2o(n)。2o(n) 的意思是,指數的成長比任何 δn 都慢,n 夠大時,無論 δ 多小都會比 2δn 快。
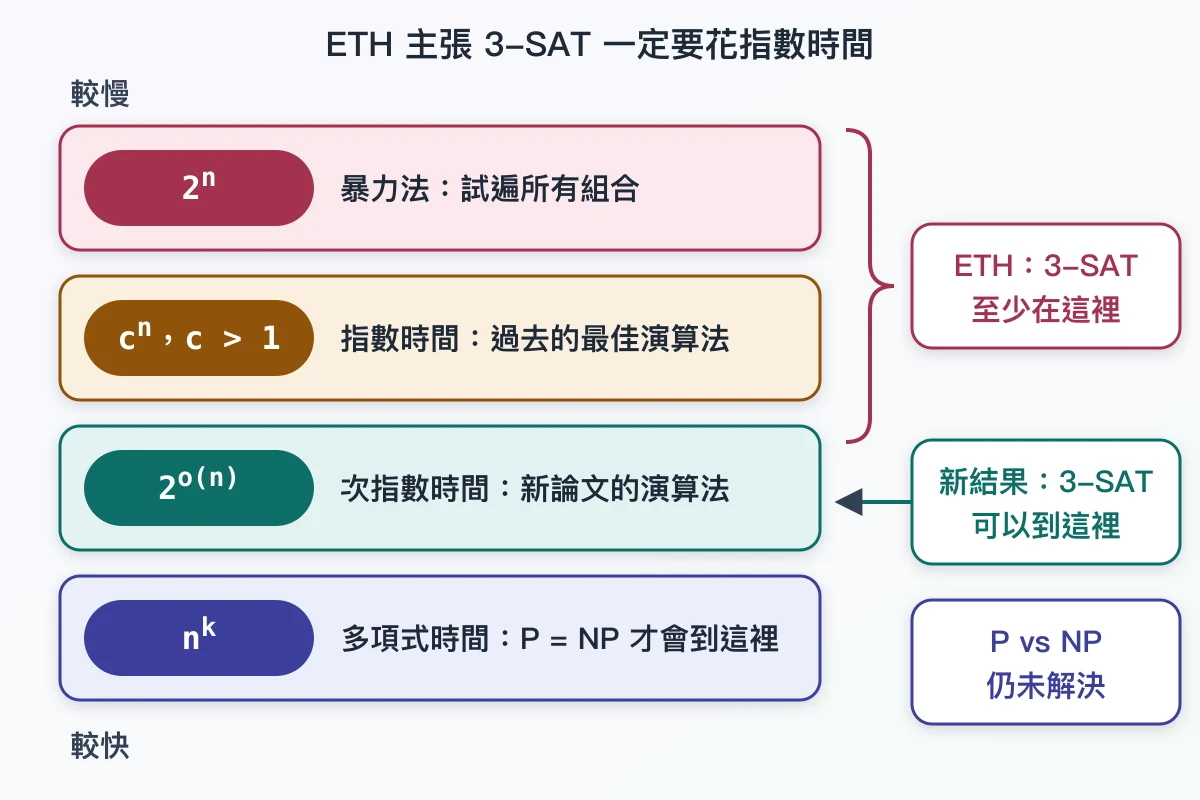
多項式時間是 nk 這類隨 n 溫和成長的時間;3-SAT 能在多項式時間解出,等於證明 P = NP。ETH 比「P ≠ NP」更強,主要用途是證明「某個問題不可能更快」:研究者把 3-SAT 歸約到其他問題,也就是把 3-SAT 改寫成那個問題,就能推出「除非 ETH 不成立,這個演算法已經是最快的」。它還有更強的版本 SETH(Strong ETH),主張子句可以有 k 個變數的 k-SAT,在 k 變大時需要接近 2n 的時間。
OpenAI 與 Anthropic 的兩篇論文
兩篇論文都宣稱,有一個確定性演算法能在 2o(n) 的時間內,精確算出 3-SAT 公式有幾組解;能算出解的數量,就能判斷有沒有解。兩者的時間界同樣是 2 的「n 除以根號 log n 左右」次方,只差在較小的修正項。
| 項目 | OpenAI | Anthropic |
|---|---|---|
| 公開日期(UTC) | 2026 年 10 月 26 日 | 2026 年 10 月 27 日 |
| 署名 | OpenAI | Claude(Anthropic) |
| 篇幅 | 67 頁 | 49 頁 |
| 主要方法 | 多項式插值 | 張量網路收縮 |
| Lean 形式化 | 較寬鬆的次指數界 | 主定理 |
OpenAI 的論文放在 GitHub 的 openai/math ,這個儲存庫收錄未命名內部模型產出的 721 篇數學與理論手稿,OpenAI 把它們定位成「原始研究資料」,不是完成的學術論文。ETH 這篇的日期是 2026 年 10 月 17 日,10 月 25 日修訂,時間界是 2n/(log n)1/2+o(1) 乘上多項式,並只用多項式大小的記憶體。
Anthropic 的論文放在 GitHub 的 anthropics/formal-math ,計數 3-SAT 解的時間界是 2O(n log log n/√log n)。論文的來源說明寫明,核心演算法是內部的 Claude 研究模型在 2026 年 10 月 16 日找到,用了 1,400 萬個輸出 tokens,過程沒有人類參與;之後研究人員才和 Claude 一起整理成論文。論文也註明,OpenAI 的內部模型獨立、同時宣稱證明了類似的結果。
兩種演算法怎麼做到
兩篇論文都先用「稀疏化引理」(Sparsification Lemma)把一般公式化成每個變數只出現在少數子句裡的形式,再各自用新方法處理。關鍵都在於,讓原本互相牽連的子句可以拆開來分別計算。
過去的方法卡在哪裡
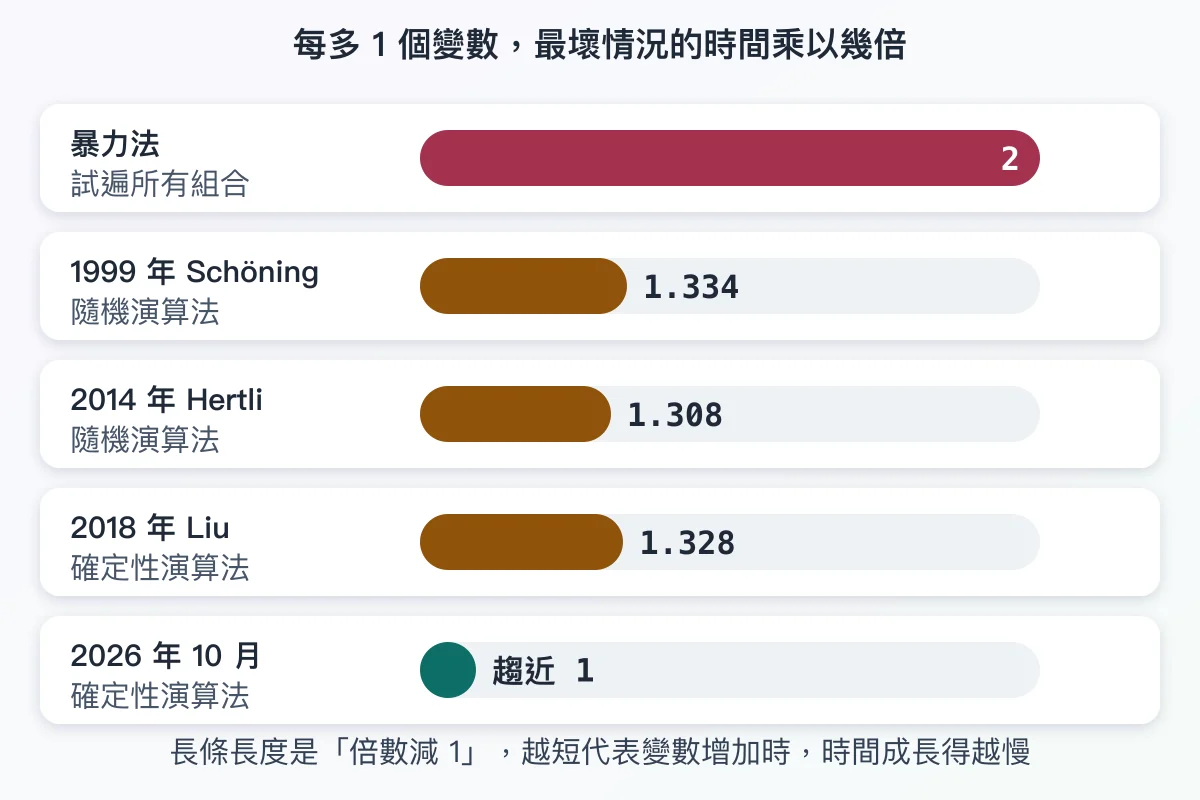
從 1980 年代起,3-SAT 演算法的進步都是把 2n 的底數往下壓:1999 年 Schöning 的隨機演算法是 (4/3)n,約 1.334n;PPSZ 系列經 Hertli 的分析壓到約 1.308n;確定性演算法的紀錄是 2018 年 Liu 的約 1.328n。底數再小,只要大於 1,時間仍然是指數成長,這正是 ETH 預測的狀況。
Anthropic 的論文說明了卡住的原因:把公式畫成圖,子句是節點,共用的變數是邊,「切成兩半、分別計算」的分治法要列舉所有跨越切口的變數值。隨機產生的公式會形成擴張圖(expander),不管怎麼切成大小相近的兩半,都會切到和 n 成正比的變數,所以分治法只能改善常數,達不到次指數。
OpenAI:用插值把各組拆開
OpenAI 的主要做法是代數方法。它把每個子句裡的變數,換成隨一個參數 T 改變的線性式,T 等於 0 時剛好還原成原本的公式。在特別挑選的其他 T 值上,變數可以分成幾組,組與組之間只透過少數幾個「共享的線性量測」互相影響。
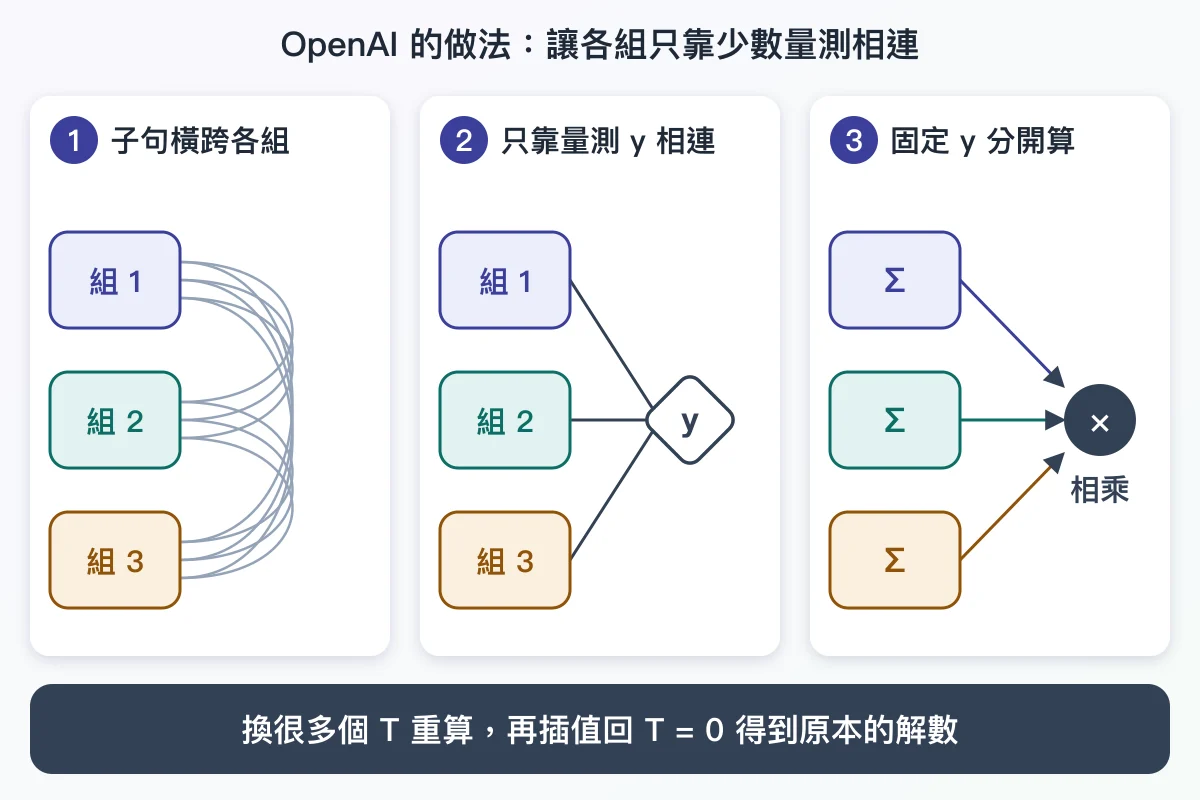
固定這些量測的值之後,每一組就能各自加總,再把結果相乘;把每一種可能的量測值都跑過再加總,就得到這個 T 值的結果,計算量遠小於列舉全部組合。對許多個 T 值重複這個過程,最後用 Hermite 插值推回 T 等於 0 的值,也就是原本公式的精確解數。論文附錄則改用張量收縮,證明較強的時間界。
Anthropic:改寫邊之後再合併節點
Anthropic 的演算法把計數問題寫成張量網路的收縮:子句是節點,邊上的位元代表共用變數的值,答案是所有節點函數乘積的總和。它的新步驟是用 1818 年就有的「八平方恆等式」,把兩條交叉、檢查變數值是否相等的邊,改寫成帶正負號的四點函數,讓節點排成方格之後,可以依列或依行合併,而不會留下太多跨組的位元。
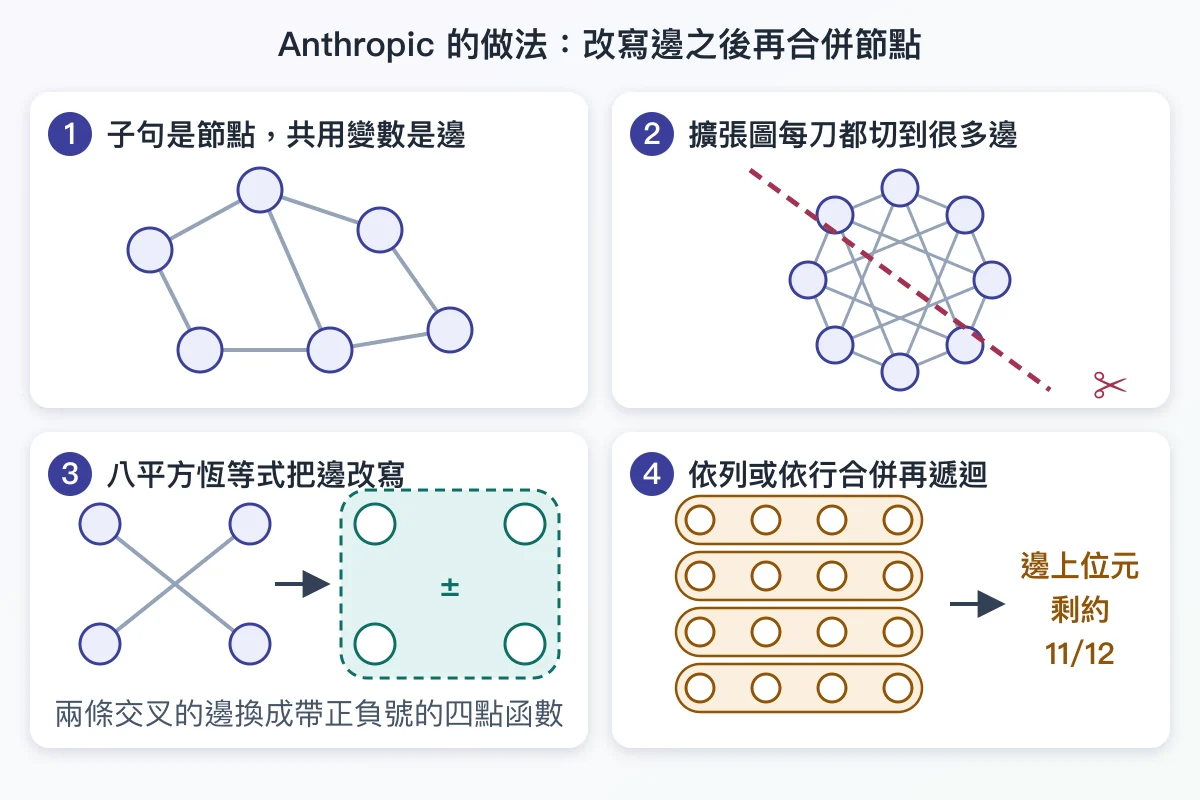
每做一層,節點之間的位元總數大約降到原本的 11/12,再把節點平衡分組後遞迴下去。層數越多,指數上的常數就越小,所以對任何 δ 都能做到 2δn 以內,這正好推翻 ETH。改寫後的函數會出現負值,每一層算的已經不是「解的數量」,而是一般的帶權總和;論文指出,這種把總和展開成帶正負號的多個張量網路、再用不同順序收縮的做法,落在過去研究分析過的模型之外。
Anthropic 的說明也提到,一般使用者能用的 Claude Opus 5.5 在 high effort 下,看過一段濃縮的關鍵描述後,就能重新推導出 3-SAT 有 2δn 演算法這個較弱的版本。
為什麼讓電腦科學界驚訝
ETH 被大量論文當作前提,多數學者也相信它成立。Anthropic 論文附上的文獻搜尋顯示,超過 800 篇論文至少有一個結果只在 ETH、SETH 或 Gap-ETH 等假設下成立;論文也引用 Ryan Williams 在 2019 年的估計,他當時認為 ETH 成立的機率約 70%,SETH 約 25%。
- 四十年沒有次指數的進展:過去的演算法只把底數從 2 壓到 1.3 左右,這也是 ETH 被廣泛接受的原因之一。
- 兩個實驗室幾乎同時找到:Anthropic 的模型在 10 月 16 日找到核心演算法,OpenAI 的論文初稿日期是 10 月 17 日。
- 由 AI 模型提出:Anthropic 寫明核心演算法沒有人類參與;OpenAI 儲存庫收錄的手稿,也幾乎都是內部模型的產出。
推翻 ETH 會帶來什麼影響
影響集中在理論:以 ETH 為前提的下界失去依據,有些問題得到新的理論演算法,但 P vs NP 與實際解題都沒有改變。
理論上的連鎖反應
OpenAI 的論文列出,這個演算法同時推翻 ETH、SETH、Gap-ETH、計數版的 #ETH 與 NSETH。部分原本依賴 SETH 的下界,例如最長共同子序列與正規表示式比對,仍可以改由 Orthogonal Vectors 假說支持,這個假說談的是「兩組向量裡有沒有互相垂直的一對」,沒有被推翻;其他只依賴 ETH 的結果,就要找新的假設重建。
新演算法也帶來一批理論上更快的結果。依 Anthropic 論文的推論,獨立集、團(Clique)、頂點覆蓋與支配集在 n 個頂點的圖上,都能在 2δn 以內解出;OpenAI 的論文則推出,計算固定顏色數的合法著色方法數,以及完美匹配的數量,也有次指數演算法。電路複雜度方面,兩篇都依 Williams 先前的定理推出,ENP 這個複雜度類別裡有問題無法用線性大小的布林電路計算;在這之前,這個類別已知最好的電路下界只有約 3.1n 個邏輯閘。
P vs NP 沒有解決
3-SAT 只是從指數時間降到次指數時間,仍然不是多項式時間。Anthropic 的論文明確寫出,結果不直接影響 P vs NP;OpenAI 的論文則指出,2o(n) 這種時間界經過一般的多項式時間歸約後不會保持,所以也不代表所有 NP 問題都有次指數演算法。
實際解 SAT 問題不受影響
Anthropic 的論文算出,在子句數是變數 5 倍的公式上,它的時間界要等變數超過 1010000 個,才會比 2n 的暴力法快;而暴力法在 100 個變數時就已經算不完。論文直接寫明,這個結果純屬漸近,和實際解公式無關。晶片驗證、排程等實務上使用的 SAT 求解器,靠的是針對真實資料結構的啟發式方法,不受這個理論結果影響。
驗證進度與 Lean 形式化的範圍
截至 2026 年 11 月 6 日,兩篇論文都還沒有完成獨立審查。OpenAI 的更新紀錄寫明,由 ETH 提出者 Impagliazzo、Paturi 與 Ryan Williams 領導的獨立工作小組,會檢查並說明這份證明;應小組的要求,OpenAI 把所有資料立即公開,讓其他人也能檢查。工作小組尚未公布結論。
Lean 形式化能讓電腦逐步檢查證明,但只能保證「寫進 Lean 的那個敘述」是對的。Anthropic 的說明寫著,Lean 會檢查證明,但沒有機器檢查陳述檔和論文說的是否一致,所以 Anthropic 刻意把陳述檔寫得很短,讓人可以自己對照;它的形式化另外通過一個獨立撰寫的檢查核心 nanoda 重新驗證。論文附錄也寫明,Lean 證明由 AI 模型撰寫、再由同一模型的其他執行個體審查,撰寫論文時還沒有已知的人類檢查過。
OpenAI 的 Lean 形式化證明的時間界是 2O(n (log log n)2/√log n),比論文宣稱的寬鬆一些,但仍是次指數,足以推翻 ETH。同一個儲存庫在 2026 年 10 月 7 日,曾因為一個正負號錯誤撤回 3 篇手稿,其他 14 篇也做了修正。
常見問答
這裡的 ETH 是以太幣嗎?
不是。這裡的 ETH 是計算複雜度理論的 Exponential Time Hypothesis(指數時間假說),和加密貨幣以太幣(Ethereum)的代號 ETH 無關,以太幣也不受這個結果影響。
ETH 被推翻代表 P = NP 嗎?
不代表。新演算法是次指數時間,不是多項式時間,P vs NP 仍然沒有答案,Anthropic 的論文也明確這樣說明。
證明已經確定是對的嗎?
截至 2026 年 11 月 6 日還沒有。兩篇都有 Lean 形式化,但由 Impagliazzo、Paturi 與 Williams 領導的工作小組尚未公布審查結論。
這會讓加密系統變得不安全嗎?
不會。常用的 RSA 與橢圓曲線加密,安全性建立在因數分解與離散對數等問題上,不是建立在 ETH 上;而且在子句數是變數 5 倍的公式上,新演算法要變數超過 1010000 個才比暴力法快,Anthropic 也明確表示這不會產生實用的演算法。
這是 AI 自己想出來的嗎?
依兩家公司的說明是。Anthropic 寫明核心演算法由內部的 Claude 研究模型在沒有人類參與下找到;OpenAI 的論文出自未命名的內部模型,以模型產出的原始研究資料公開。
參考來源
- GitHub: The Exponential Time Hypothesis is False (OpenAI 的論文)
- GitHub: openai/math History (OpenAI 數學儲存庫的更新紀錄)
- GitHub: openai/math The Exponential Time Hypothesis is False (OpenAI 的 Lean 形式化範圍)
- GitHub: A 2^o(n) Time Algorithm for 3-SAT (Anthropic 的論文)
- GitHub: anthropics/formal-math A 2^o(n) Time Algorithm for 3-SAT (Anthropic 的 Lean 形式化與說明)
- Hexagon: A 2^o(n) Time Algorithm for 3-SAT (Anthropic 論文的預印本頁面)