Jev 決策模型推出後大受歡迎,OpenAI 也緊跟著推出自己的決策模型 Decisions API,背後使用的正是 gpt-6-luna,但它不再生成一段文字,而是直接從固定選項中做出決定,回傳各選項的機率與信心值。新的 Decisions API 背後也是 gpt-6-luna,會比直接使用 gpt-6-luna 更好嗎?
本文除了實測 Decisions API,也同時比較熱門的 Jev、本機決策模型 Laya,以及直接使用原本的 gpt-6-luna 進行決策。分別進行有正確答案的計概選擇題,與需要考慮決策者偏好的文章分類資料,實際比較決策的準確度、執行速度、花費,以及回傳的信心值能不能判斷答案是否可靠。
OpenAI Decisions API 是什麼
Decisions API 是 OpenAI 在 2026 年 9 月 29 日 DevDay 發表的 API,當時是有限預覽,目前為 public beta,官方文件寫著預計幾週內正式推出。它只支援一個模型 gpt-6-luna,端點是 POST /v1/decisions。DevDay 其他發表內容整理在 OpenAI DevDay 2026 重點整理 。
決策模型與一般 LLM 的差別
分類、路由這類判斷只需要從固定選項挑一個值,決策模型就是為這種工作設計的。客服信要轉給哪個部門、Agent 下一步該呼叫哪個工具、使用者上傳的內容要不要送人工審核,答案範圍早就確定,程式要的是能直接接上分支的值,而不是一段解釋。
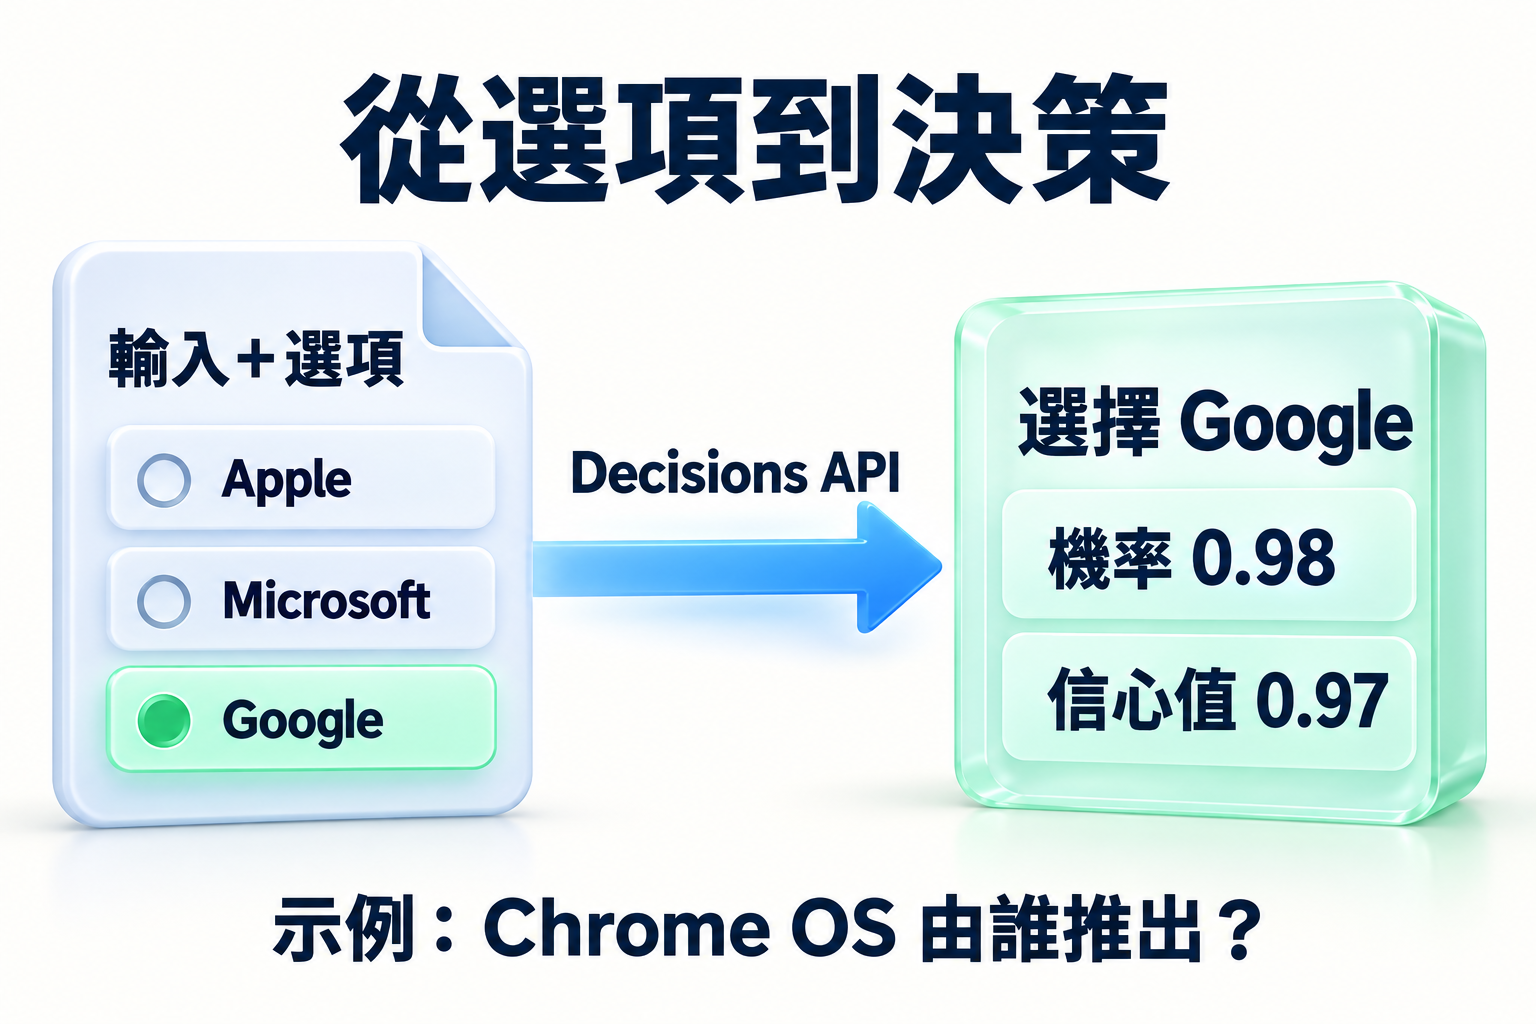
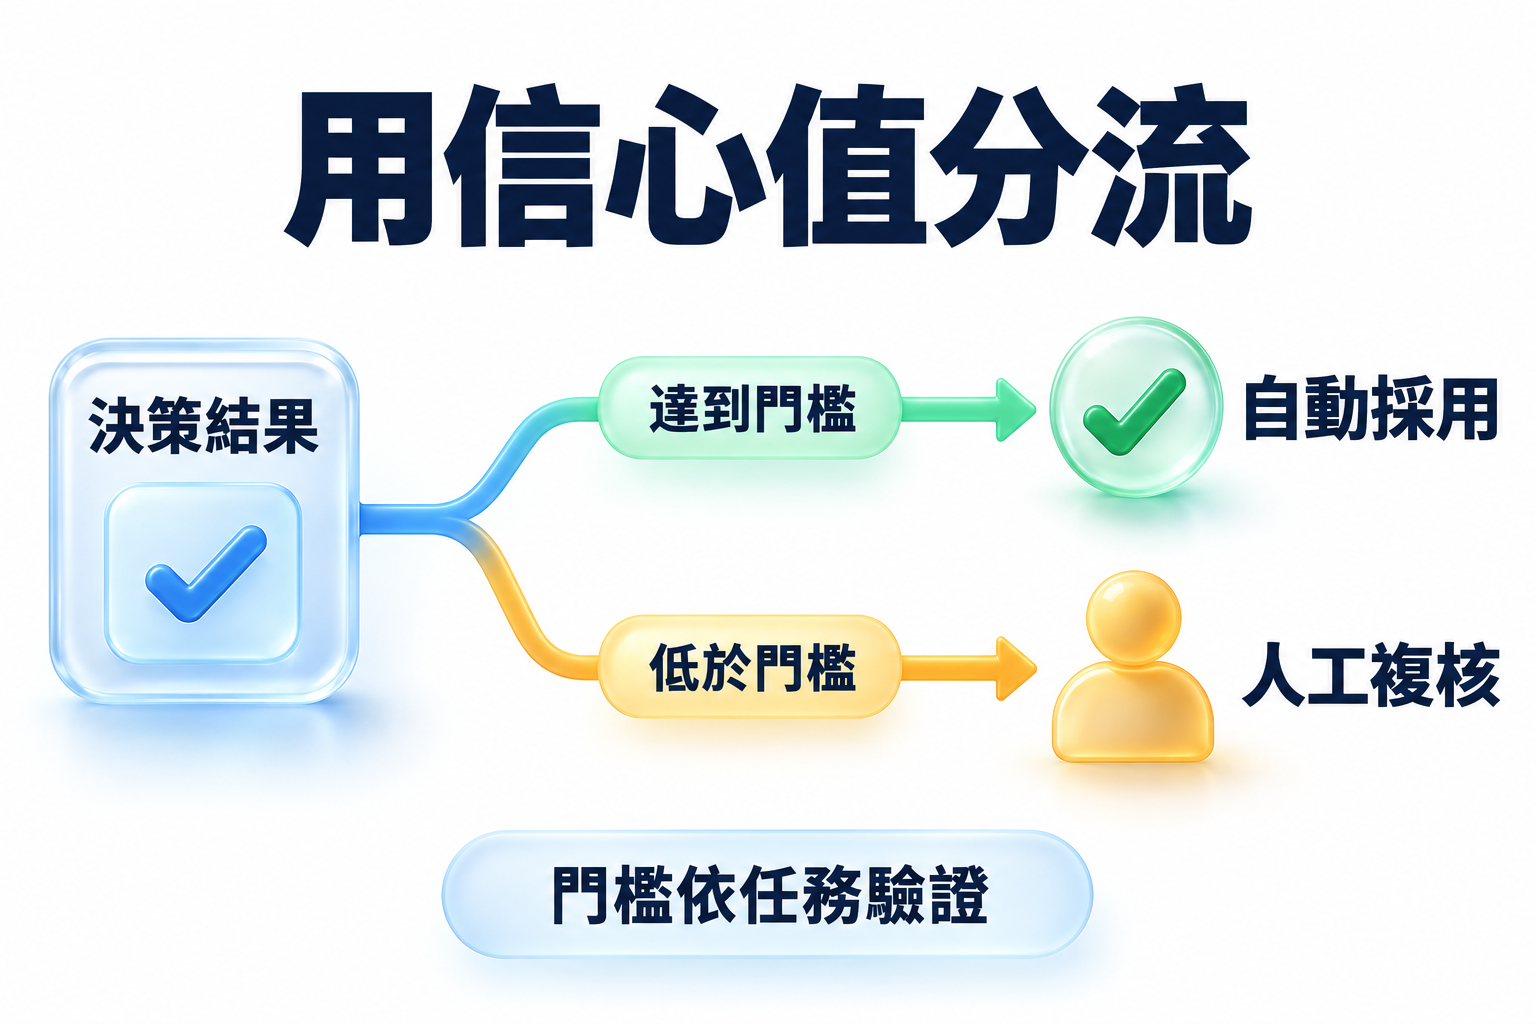
用一般 LLM 也做得到,常見做法是在提示詞列出選項、要求模型輸出 JSON。不過這樣有三個代價:模型要逐字生成答案,速度比較慢;輸出 token 要付費;而且要知道模型有多少把握,得另外開 logprobs 自己換算。決策模型把這三件事合成一個介面,回應直接帶各選項的機率與信心值,程式就能設門檻:信心夠高自動採用,不夠高交給人看。
TypeSafe AI 把這種只做選擇、不生成文字的模型稱為 System One 模型。代表模型 Jev 是 TypeSafe AI 在 2026 年 9 月推出的雲端決策模型,可以從 TypeSafe 的 API 或 OpenRouter 等平台呼叫。Laya 是 Convai Innovations 在 2026 年 9 月 18 日以 Apache 2.0 授權開源的同類模型,問題格式與 Jev 相同,能在自己的電腦上執行,適合客服分流、Agent 選工具這類判斷。OpenAI Decisions API 則是 OpenAI 自家的同類服務。
Decisions API 的題型與價格
一般的 LLM 回傳一段文字,Decisions API 回傳的是「答案型別」。官方提供三種題型:
| 題型 | 回傳內容 | 適合的問題 |
|---|---|---|
choice | 選中的值、每個選項的機率、confidence | 這封客訴該轉給哪個部門、這篇文章屬於哪個分類 |
score | 依機率加權的等級分數、每個等級的機率、confidence | 問題的嚴重程度是低、中、高 |
predicate | 條件成立的機率 | 這張照片是否需要送人工檢查損壞 |
輸入可以是文字或圖片(base64 data URL 或公開網址,不支援 file_id)。價格是每百萬 input tokens 0.10 美元,沒有 output 與快取費用;區域處理與長 context 另有加成。資料保存方面,符合資格的客戶可以使用 Zero Data Retention 與 HIPAA,也能選擇在美國或歐洲處理資料。
請求與回應的格式
以下是計概測驗裡實際送出的一題。題目放在 input,選項寫成一個 choice 題,value 是程式拿來判斷的值,description 是給模型看的選項說明:
# https://klab.tw/2026/10/openai-decisions-api-review/
# 金鑰放在環境變數 OPENAI_API_KEY
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "題目:Chromebook 使用的是哪家公司推出的作業系統?",
    "questions": [{
      "type": "choice",
      "name": "answer",
      "instructions": "這是一題資訊概論單選題。依題目選出唯一最正確的選項。",
      "choices": [
        {"value": "1", "description": "Apple"},
        {"value": "2", "description": "Microsoft"},
        {"value": "3", "description": "Google"},
        {"value": "4", "description": "IBM"}
      ]
    }]
}'回應(usage 只留兩項):
{
  "answers": [{
    "type": "choice",
    "name": "answer",
    "choice": "3",
    "probabilities": [
      {"value": "1", "probability": 0.0},
      {"value": "2", "probability": 0.01},
      {"value": "3", "probability": 0.98},
      {"value": "4", "probability": 0.01}
    ],
    "confidence": 0.97
  }],
  "usage": {"input_tokens": 159, "output_tokens": 0}
}
程式只要讀 choice 就能直接接到 switch 或 if 分支,不必從一段文字裡解析答案。confidence 和最高機率很接近,但不是同一個數字:實測 200 題,confidence 一律小於或等於最高機率,差距多半在 0.05 以內,選項機率分散的題目會差到 0.2 以上。Decisions API 沒有 temperature 參數,實測回傳的選項每一題都是機率最高的那個。
參與比較的決策模型與對照組
| 開發者 | 在哪裡執行 | 本次的呼叫方式 | |
|---|---|---|---|
| OpenAI Decisions | OpenAI | 雲端 | POST /v1/decisions,模型 gpt-6-luna |
| TypeSafe Jev | TypeSafe AI | 雲端 | OpenRouter 的 Decisions 端點(alpha),模型 typesafe/jev-1.14 |
| Laya | Convai Innovations(Apache 2.0 開源) | 本機(M4 Pro、64GB 記憶體的 Mac) | Python 套件 laya 0.3.20,多語版 checkpoint |
| 對照:一般 gpt-6-luna | OpenAI | 雲端 | Responses API,不思考、temperature: 0、強制輸出 {"answer": "A"},信心值取 logprobs |
Jev 的功能、價格與題型,在 Jev 是什麼?TypeSafe System One 決策模型 有完整介紹。Laya 的安裝步驟、速度與記憶體實測,以及客服分流、Agent 選工具等測試,整理在 Laya 評測與使用教學 。
對照組用來回答一個問題:同樣是 gpt-6-luna,改走 Decisions API 換到了什麼、少了什麼。對照組關掉推理,讓它和 Decisions API 一樣一次選出答案。
兩種測試:計概選擇題與文章分類
四種方式都跑同樣兩組題目,每題一次請求、依序送出不並發,每個模型 1 輪,測試時間是 2026 年 10 月 20 日。
計算機概論:考知識與計算
題目來自計算機概論單選題庫,共 200 題,涵蓋硬體、網路、多媒體、程式設計,也有進位制轉換、補數這類要逐位計算的題目。每題 4 個選項,亂猜的期望正確率 25%。這組題目有標準答案,能直接比較誰比較準,但它考的是知識,不是決策模型主打的用途,可比較模型的常識與知識能力。
文章分類:照業務規則分類
第二組更接近決策模型的實際用途。題目是 klab.tw 已發布的 186 篇文章,每篇給模型看標題與摘要,從部落格的 11 個分類中選一個,再和文章原本的分類比對。選項不只是分類名稱,還附上每個分類的說明,例如「本機AI:本機部署——在自己的電腦或伺服器上部署、執行模型⋯⋯雲端服務上跑開放權重模型不算」,指示文字也附了 5 條判斷例。
實務上很多分類都是這樣:類別不是圖書館那種通用標準,而是依團隊需求自訂,界線也由團隊決定。同一篇「用 Google AI Studio 跑 Gemma 4」的文章,從字面看像在講模型,但在本部落格的規則裡歸到「AI開發」,因為重點是雲端平台的使用方式。模型能不能照著一份分類說明分出跟人一樣的結果,比通用知識更能看出它在實際系統裡好不好用。
分類沒有唯一正解,有些文章放在兩個分類都說得通,所以這組的成績稱為「一致率」,代表給了說明與範例之後,模型回答跟使用者期望選項一致的比率。
計概 200 題結果
Jev 最準,計算題拉開差距
| 模型 | 正確率 | 每題時間(中位數) | 200 題總時間 | 總花費 |
|---|---|---|---|---|
| TypeSafe Jev | 97.5% | 0.66 秒 | 147.3 秒 | $0.0034 ≈ 新台幣 0.11 元 |
| 一般 gpt-6-luna | 95.5% | 1.34 秒 | 287.2 秒 | $0.0040 ≈ 新台幣 0.13 元 |
| OpenAI Decisions | 92.5% | 0.27 秒 | 59.8 秒 | $0.0038 ≈ 新台幣 0.12 元 |
| Laya(本機) | 33.5% | 0.015 秒 | 3.9 秒 | 0(本機) |
三種雲端方式的差距幾乎全來自計算題。挑出 24 題要計算的題目(進位制轉換 14 題,補數、邏輯運算、圖片容量等 10 題),Jev 答對 20 題,一般 gpt-6-luna 15 題,OpenAI Decisions 10 題;其餘 176 題三者都在 99% 以上。Decisions API 錯的 15 題裡有 11 題是進位制轉換與補數,例如十進位 59.75 轉二進位、10101010 取 2 的補數。
Jev 答對的計算題裡,有 9 題信心值低於 0.6,每題花的時間也和其他題一樣(約 0.7 秒),看起來比較像是從選項的位數、尾數比對刪去,而不是一步步算出來。這是從結果推測的,API 不提供推理過程。
Laya 答對 67 題,亂猜的期望值約 50 題,每題都選第 2 個選項也能對 57 題。它的設計用途是客服分流、選工具這類判斷,計概這種要知識與計算的題目不在它的能力範圍內。
文章分類結果
三種雲端方式約 85% 一致
| 模型 | 一致率 | 每篇時間(中位數) | 186 篇總時間 | 總花費 |
|---|---|---|---|---|
| 一般 gpt-6-luna | 87.6% | 1.57 秒 | 679.2 秒 | $0.0152 ≈ 新台幣 0.49 元 |
| TypeSafe Jev | 87.1% | 0.61 秒 | 115.4 秒 | $0.0092 ≈ 新台幣 0.30 元 |
| OpenAI Decisions | 84.4% | 0.31 秒 | 66.5 秒 | $0.0149 ≈ 新台幣 0.48 元 |
| Laya(本機) | 40.3% | 0.04 秒 | 7.2 秒 | 0(本機) |
分類說明寫清楚,一致率提高約 7 個百分點
同一批文章先跑過一次初版:只給摘要,分類說明是舊版,三個 AI 分類只列關鍵字,沒有寫出界線。之後依測試中發現的分歧改寫說明,例如明訂「本機AI」只算本機部署、「AI模型」專門介紹新模型,並依新規則人工調整了 16 篇文章的分類。用同一份新分類比對,兩次的差異如下:
| 初版(只給摘要、舊說明) | 正式版(標題+摘要、新說明+判斷例) | 改分類的 16 篇答對 | |
|---|---|---|---|
| OpenAI Decisions | 77.4% | 84.4% | 1 → 12 篇 |
| 一般 gpt-6-luna(JSON) | 80.6% | 87.6% | 1 → 13 篇 |
| TypeSafe Jev | 79.0% | 87.1% | 0 → 12 篇 |
| Laya(本機) | 40.9% | 40.3% | 1 → 1 篇 |
三種雲端方式都提高 7~8 個百分點,改過分類的 16 篇從幾乎全錯變成對 12~13 篇,代表新說明確實把分類理由傳達給了模型。自訂分類的準確度,很大一部分取決於分類說明寫得夠不夠具體;補齊說明的界線和例子,對一致率的影響可能比換模型更大。
最常分歧的分類
「AI開發」49 篇三種雲端方式幾乎全對,Apple、Java、系統與 DevOps 也都在 9 成以上。分歧集中在「AI模型」:28 篇只對 18~22 篇,模型降價的新聞常被分到「AI開發」(價格屬於「AI模型」,方案與額度屬於「AI開發」),能在本機跑的新開放權重模型則常被分到「本機AI」。三種雲端方式都分得和原分類不一樣的有 14 篇,多半是這類兩邊都說得通的文章。
Laya 在「Apple」21 篇全對,「AI開發」49 篇卻一篇都沒選對,多被分到「程式開發」「系統與 DevOps」或「生活」,選對的多是關鍵字明顯的分類。
信心值:哪些答案可以直接採用
決策模型的信心值用來設門檻:高於門檻自動採用,低於門檻交給人看。好用的信心值要能把錯的答案集中在低分區,門檻一設就能攔下大部分錯誤。下表列出每種方式在兩項測試中較好用的門檻:
| 計概 200 題 | 文章分類 186 篇 | |
|---|---|---|
| TypeSafe Jev | 門檻 0.6:自動採用 184 題,全對,5 題錯題全攔下 | 門檻 0.9:自動採用 133 篇,95.5% 一致,24 篇不一致攔下 18 篇 |
| OpenAI Decisions | 門檻 0.5:自動採用 186 題,97.8% 正確,15 題錯題攔下 11 題 | 門檻 0.9:自動採用 156 篇,89.1% 一致,29 篇攔下 12 篇 |
| 一般 gpt-6-luna(logprobs) | 門檻 0.99:自動採用 182 題,99.5% 正確,9 題錯題攔下 8 題 | 任何門檻都攔不到:不一致的 23 篇信心值幾乎都接近 1 |
| Laya(本機) | 分不出對錯,答對與答錯的平均信心值幾乎一樣 | 門檻 0.7:只有 18 篇過門檻,但全部一致 |
Jev 的信心值在兩項測試都比較能把錯的答案集中在低分區。OpenAI Decisions 在計概題的表現接近,分類題就弱了一些。一般 gpt-6-luna 的 logprobs 機率太有把握,錯題也常在 0.96 以上,計概題要把門檻拉到 0.99 才有用,分類題則完全分不開。同一個模型,分類題 Decisions API 的信心值明顯比 logprobs 換算的好用;計概題則是 logprobs 的排序更好,只是門檻要拉到 0.99。
Decisions API 也會有「很有把握的錯」:計概有一題問 800×600 全螢幕 256 色圖片需要多少記憶體,它以 0.99 的信心值選錯。官方文件建議用自己應用的標註資料決定門檻,並衡量誤判與漏判的代價,上表的門檻只適用於這兩組題目。
速度與花費
OpenAI 官方宣稱 Decisions API 比 Responses API 快約 10 倍。實測和關掉推理的 Responses API 相比,兩項測試的每題中位數都快約 5 倍,分類題的總時間差約 10 倍。Jev 每題約 0.6 秒,介於兩者之間。Laya 在本機每題 15~40 毫秒,比雲端快一個數量級。
| 單價(每百萬 tokens) | 計概 200 題實際花費 | 文章分類 186 篇實際花費 | |
|---|---|---|---|
| OpenAI Decisions | input $0.10,output 不收費 | $0.0038 ≈ 新台幣 0.12 元 | $0.0149 ≈ 新台幣 0.48 元 |
| TypeSafe Jev | input $0.042,output 不收費 | $0.0034 ≈ 新台幣 0.11 元 | $0.0092 ≈ 新台幣 0.30 元 |
| 一般 gpt-6-luna(JSON) | input $0.10、output $0.50 | $0.0040 ≈ 新台幣 0.13 元 | $0.0152 ≈ 新台幣 0.49 元 |
| Laya(本機) | 免費(本機電費與硬體另計) | 0 | 0 |
Jev 每題送出的 input tokens 比 Decisions 多 5 成到一倍,但單價不到一半,總花費在三種付費方式中最低。分類題比計概題貴,是因為每篇都要附上 11 個分類的說明和判斷例。換算下來,每 1,000 次分類 Decisions 約 0.08 美元、Jev 約 0.05 美元。
綜合評分
把三種付費方式的正確率(一致率)、時間、花費各換算成 0~100 分,取平均當綜合分數。正確率直接用百分比;時間與花費以最好的為 100 分,其他依「最好的 ÷ 自己」換算。Laya 沒有金額,速度又快一個數量級,放進來會把三種雲端方式的時間分數壓到約 10 分,所以不評分。
OpenAI Decisions 兩項測試都拿最高分,主要贏在速度;文章分類時 Jev 只差 0.4 分。這套算法會放大很小的金額差距:分類題 Jev 花 0.0092 美元、Decisions 0.0149 美元,花費分數就差到 100 比 61.5,實際只差約 0.006 美元。正確率卻直接用百分比,三者只差幾分。因此這張表偏重速度與花費,比較在意準確度時,直接看正確率那一欄。
依用途選擇決策模型
- 要準、要讓大部分案件自動處理:TypeSafe Jev。兩項測試都名列前茅,信心值比較能分出對錯,花費在三種付費方式中最低;每題約 0.6 秒。
- 要即時回應、已經在用 OpenAI:OpenAI Decisions API。每題約 0.3 秒,計概 92.5%、分類 84.4%;還支援圖片輸入與 OpenAI 的資料保存選項。要計算的題目是它的弱項。
- 資料不能離開本機、判斷又很簡單:Laya。每題幾十毫秒、不花 API 費用,但只適合關鍵字明顯的分流;11 個分類的文章分類只有 40% 一致,計概題接近亂猜。
- 一般 LLM 輸出 JSON:文章分類的一致率最高,但每題比 OpenAI Decisions 慢約 5 倍,信心值在分類題攔不到錯誤。除非不想接新的 API,否則決策型 API 更合適。
這是目前測試的結果,每個模型只跑 1 輪。OpenAI Decisions API 仍是 public beta,OpenRouter 的 Jev 端點是 alpha,Laya 也持續更新,模型與價格都可能改變。
常見問答
Decisions API 跟直接使用 gpt-6-luna 有什麼差別?
兩者使用同一個 gpt-6-luna,差在呼叫方式與回傳內容。Decisions API 專門處理固定選項的判斷,直接回傳選中的值、各選項機率與信心值,不生成文字,也不收 output token 費用。透過 Responses API 直接使用 gpt-6-luna,則由模型生成文字或 JSON,輸出 token 需要付費;本文對照組要求回傳 JSON 並關閉推理。一般 JSON 回應不會直接附上信心值,需要額外要求 API 回傳 logprobs(輸出 token 的對數機率),再由程式取出答案選項的數值、換算成機率,作為本次比較的信心值。
這次兩項測試中,Decisions API 的每題回應時間中位數約快 5 倍,但正確率與分類一致率都略低於直接輸出 JSON 的做法。分類題的信心值則以 Decisions API 比較能分出一致與不一致的答案。只需要分類、選工具或分流時,可以採用 Decisions API;需要生成說明或其他文字內容時,使用 Responses API。
Decisions API 可以選擇其他模型嗎?
不行,目前只支援 gpt-6-luna。同一個模型也能透過 Responses API 一般呼叫,本文的對照組就是這樣做的。
Decisions API 可以設定 temperature 嗎?
不行,請求沒有 temperature 參數。實測 200 題,回傳的選項每一題都是機率最高的那個,行為等同 temperature 0。
決策模型適合回答知識題嗎?
雲端的 Jev 與 OpenAI Decisions 可以,非計算題都在 99% 以上;要逐步計算的題目就比較容易錯。本機的 Laya 不適合,計概 200 題只對 33.5%,接近亂猜。
信心門檻要設多少?
沒有通用數字,要依模型與任務測。同樣是 OpenAI Decisions,計概題門檻 0.5 就能攔下大部分錯誤,分類題設到 0.9 也只攔下 4 成。做法是準備一批已知答案的資料,看各門檻下自動採用的正確率和要轉給人看的數量,再依誤判的代價決定。
參考來源
- OpenAI API: Decisions (Decisions API 使用指南)
- TypeSafe AI: Models (Jev 版本與價格)
- Hugging Face: convaiinnovations/laya (Laya 模型卡)